raft共识算法是实现强一致性的通用解法,结合In Search of an Understandable Consensus Algorithm、CONSENSUS: BRIDGING THEORY AND PRACTICE 两篇论文以及etcd-raft和openraft工业级源码,本文重在对Raft安全性的推导(论文中给定的行为如何确保安全性)、配置变更实现、复制状态机的讨论(日志、快照、WAL)。不做算法内容讲解,常见优化以后再讨论。
在上一篇文章分布式系统探幽-建模与挑战 - 知乎 中讨论到,共识算法建立在部分同步网络 + 容忍拜占庭错误 + 非网络分区时保障安全性(决定一致的值)和活性(有限时间内决定) + 网络分区时保障安全性 四个前提的基础上。后续讨论默认上述前提,不再赘述。
Raft安全性
论文中提到,Raft算法的行为可以同时保证以下5条性质的成立:
- Election Safety: At most one leader can be elected in a given term.
- Leader Append-Only: A leader never overwrites or deletes entries in its log; it only appends new entries.
- Log Matching: If two logs contain an entry with the same index and term, then the logs are identical in all entries up through the given index.
- Leader Completeness: If a log entry is committed in a given term, then that entry will be present in the logs of the leaders for all higher-numbered terms.
- State Machine Safety: If a server has applied a log entry at a given index to its state machine, no other server will ever apply a different log entry for the same index.
为了严谨,不做循环论证,我们声明,将leader append-only和图中给出的行为作为推导前提,目标是推导出剩余的四条性质,且这些性质同时满足。推导出性质后,我们再反过来理解,Raft为什么要这样设计,不这样会发生什么。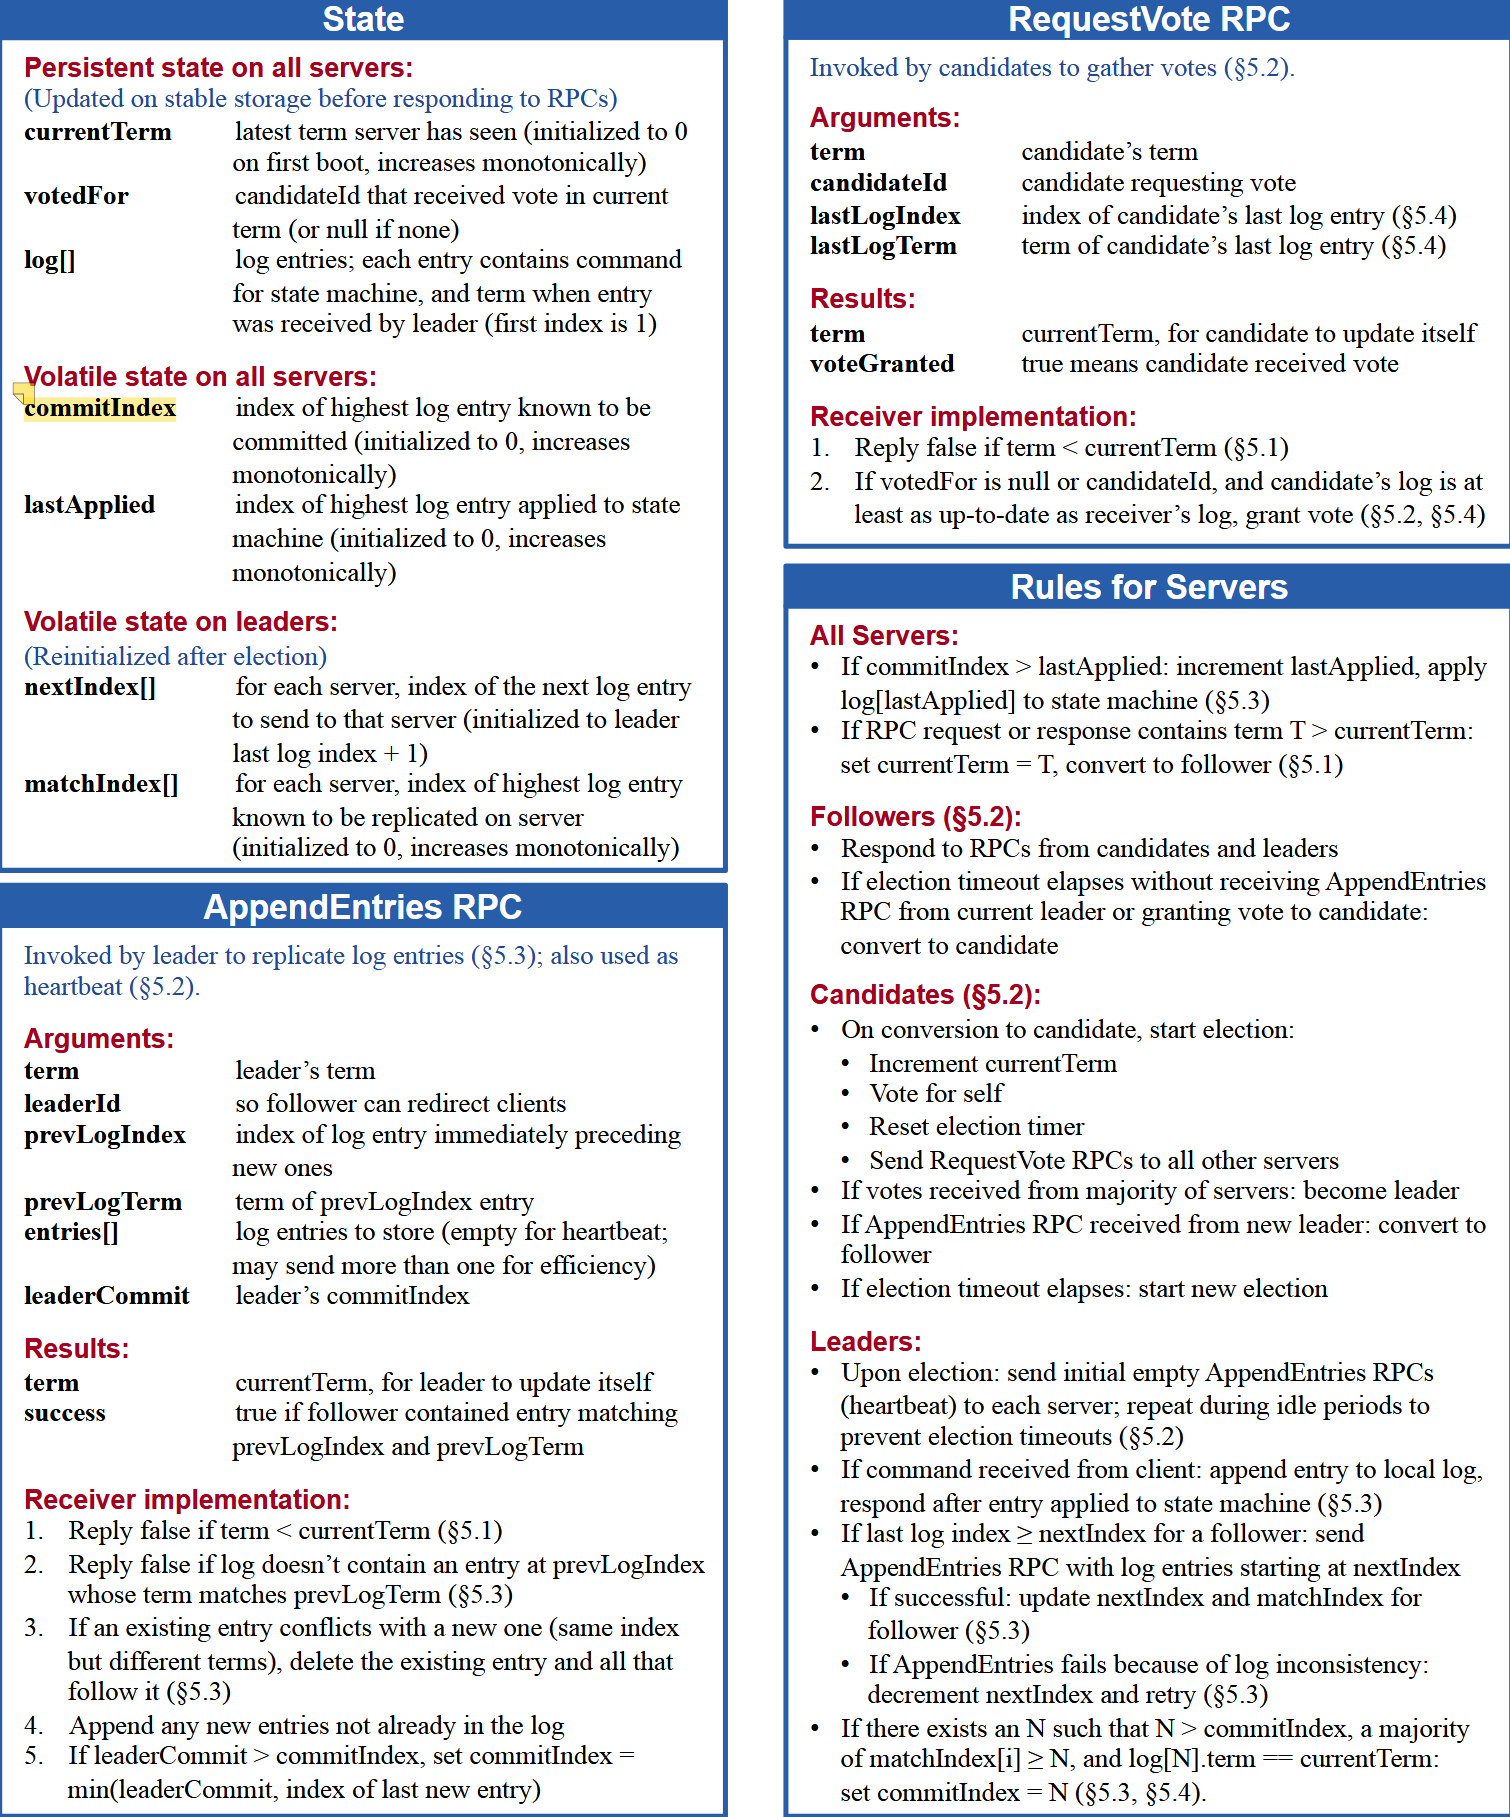
性质推导
推导顺序: Election safety -> Log Match -> Leader Completeness -> StateMachine safety
Election safety证明前提:
- 一个从节点在一个任期内只会投出一张票(见
requestVote行为) - 鸽巢原理(
n+1个物品放到n个盒子,至少有一个盒子装着至少2个物品 => 奇数个节点,两个多数派之间必然至少有一个共同节点)
证明方法:反证法。
证明过程:如果集群在一个任期内选出了两个主节点,因为获得多数派投票的节点才能成为主节点,两个多数派之间至少有一个相交节点,即某个节点违反了投票原则,与前提矛盾,不成立(代码写错了,理论没问题)。
结论: 一个任期最多只有一个领导人当权(可以没有)
LogMatch证明前提: Election Safety + Leader AppendOnly + 从节点日志从最近匹配点之后的日志被主节点覆盖(接收原则第三条)
证明方法:强归纳法
证明过程:
- $P(0)$: 所有
Raft节点在初始态具有相同的日志,要么都为空,要么具有相同的伪日志 - $P(K)$: 节点A、B持有相同的日志条目
e表示为(index, term),该条目一定是当前任期的领导人追加的,由领导人的追加行为对每个节点寻找公共前缀[1,k],然后复制日志(k,i]到从节点,得知节点的日志条目(k,i]相同由当前领导人的复制保证;顺着日志k继续向前递归,最终可以定位到初始相同前缀$P(0)$; - 得证
结论:如果两个节点含有相同的日志(index,term),那么它们此前的日志完全相同
Leader Completeness证明前提: Election Safety + Leader AppendOnly + LogMatch + 投票原则2(投给日志至少和投票者一样新的节点先比较term,再比较index)
证明方法:反证法
证明过程:
- 在任期
T节点u成为领导人,并复制日志到多数节点,并且在多数节点上都提交了该日志e,随后节点u崩溃,集群选出新的领导人v - 假设领导人
v不含日志e,因此它新提交日志后根据日志匹配原则会覆盖掉其他节点上的日志e,由于拿到多数选票 和 多数节点复制日志才能提交,这两个多数派必然有一个共同节点,该节点违反了投票规则2,因为v的日志并非至少和该节点一样新 - 得证
结论:在某个任期内被提交的日志,会保留在更高任期领导人的日志中
StateMachine safety推导起来很容易: 日志被提交后才能被应用,提交过的日志依旧存在于新的领导人日志中,因此一个index对应的日志只会被应用一次
设计溯源
根据性质我们反过来理解设计,如果raft不这样做,会发生些什么,从而加深对于raft设计的理解。
讨论以下问题:
- 为什么
vote需要持久化? - 投票时比较日志是否一样新为什么按照
(term,index)而非(index,term)的顺序 leader为什么不能主动提交上一个任期的日志?
raft算法中必须持久化的元数据称为硬状态,可选持久化的元数据称为软状态。etcd-raft中定义:
SoftState:Leader id + NodeState。软状态是不必持久化的,可选被处理的状态。通常对外暴露用于监控领导人的转移(侧面反应系统压力、网络问题)。即使丢失也不影响系统正确性。HardState:Term + Vote + Commit,必须被持久化的信息,丢失会影响正确性
不持久化Term崩溃重启后会接收处理过时消息;不持久化Commit崩溃重启后会重复应用日志导致违反状态机安全性质。
不持久化Vote则会导致违反Election safety:
- 5节点集群,
term 5领导人; 节点B,C投票给A; - C崩溃重启
- 由于网络波动,A发送给节点的第一条空
append entry延迟; - 节点D超时开启选举,接收到C,E的投票,成为
term 5的领导人 - 系统脑裂
使用Raft-paper图7分析问题2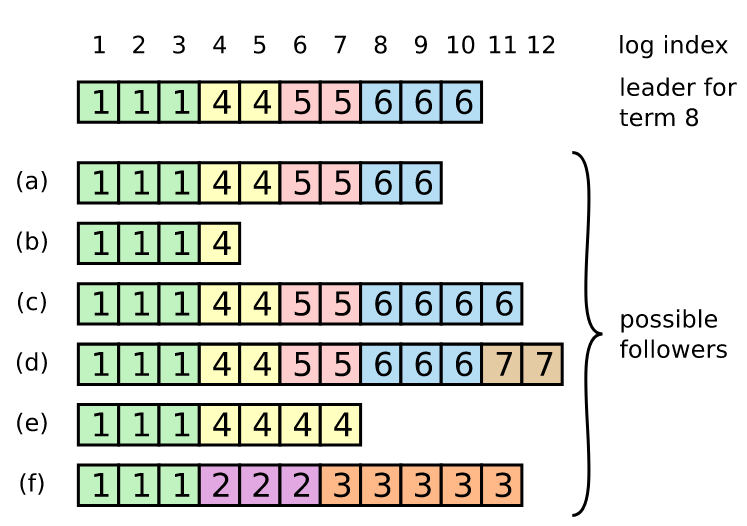
假设在任期8, 节点f和其他节点同时开始竞选,如果按照(index,term)的顺序比较日志是否更新,节点f成为领导人后,会覆盖掉其他节点已经提交的日志(t4,i4)...,(t6,i9); 违反Leader Completeness
Term就是Raft算法的逻辑时间,更高任期的消息更贴近source of truth,必须具有更高的优先级
使用Raft图8分析问题3: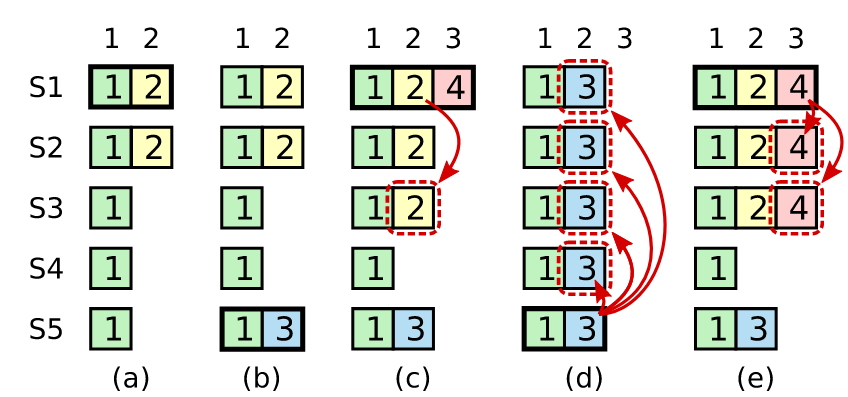
- (a) S1是领导人并且部分复制日志(
term2, index2) - (b) S1崩溃; S5当选任期3的领导人并获得S3,S4的投票,生成日志(
term3,index2); - (c) S5崩溃; S1重启并当选领导人并继续复制,日志(
term2,index2)复制到多数机器上但是没提交 - (d) S1崩溃,S5再次当选领导人(S2,S3, S4的选票),覆盖其他节点上的日志(
term2,index2) - (e) S1在日志(
term2,index2)复制到多数并提交后崩溃,S5无法当选领导人,S1崩溃重启后复制日志(term4,index3)到多数机器并提交
日志被复制到多数节点与日志被提交之间存在时间差
主节点发送
MsgAppend时携带最新的CommitIndex, 从节点在发送MsgAppendRes时携带自身的lastLogIndex主节点处理
MsgAppendRes时如果检测到多个节点的matchIndex/lastLogIndex = N,那么将自身的CommitIndex设置为N等到下一次发送
MsgAppend/MsgHeartBeat时从节点才能推荐commit状态
S5在图(d)当选就是因为日志复制与提交时间差的存在。
如果领导人可以提交此前任期的日志,如在图(c)中复制日志(term2,index2)到S3后便主动提交,随后S1可能就应用了该日志,应用完毕之后崩溃,S5当选,覆盖日志index2, 随后提交并应用。状态机安全属性被破坏了,一个index对应两条不同的日志,并且都被应用,外部客户端观测到不一致的状态。
由于Leader Append + LogMatch可以保证系统总是能找到相同的前缀,LeaderCompleteness可以保证低任期已提交的日志出现在高任期领导人的日志中,因此只要系统正常运行,此前任期提交的日志总是会被应用。
配置变更
配置变更是Raft算法中最有意思,最微妙的地方,推荐补充阅读阅读(1 封私信) Raft 成员变更的工程实践 - 知乎 了解单步变更算法,再阅读(1 封私信) Raft 成员变更上踩的坑 - 知乎 体会JointConsensus的本质。
依次探讨如下问题:
- 一次$C_{old}$->$C{new}$的配置变更是否可以支撑多个节点变更
- 单点变更算法的局限与反思
JointConsensus的正确性保证
在配置变更时打破Raft算法安全性的第一块多米诺骨牌是Election Safety: 一个任期最多只有一个领导人。
在分析时序与系统状态时注意日志的生命周期(见下文状态机相关讨论): 严格区分 追加、提交、应用三个状态。
在Raft论文中作者将单点变更算法设置为追加成功就生效,这会导致在配置变更时如果切换领导人,那么两个多数派可能不相交,因此导致已提交的日志被覆盖。作者后续意识到这个问题,并指正。详细的示例见(1 封私信) Raft 成员变更的工程实践 - 知乎 。
后续讨论时默认配置变更和普通日志一样,提交后生效。并且新领导人上任后必须提交一条no-op消息才能执行状态变更。
借用Raft-Extend-Paper图4.2讨论第一个问题: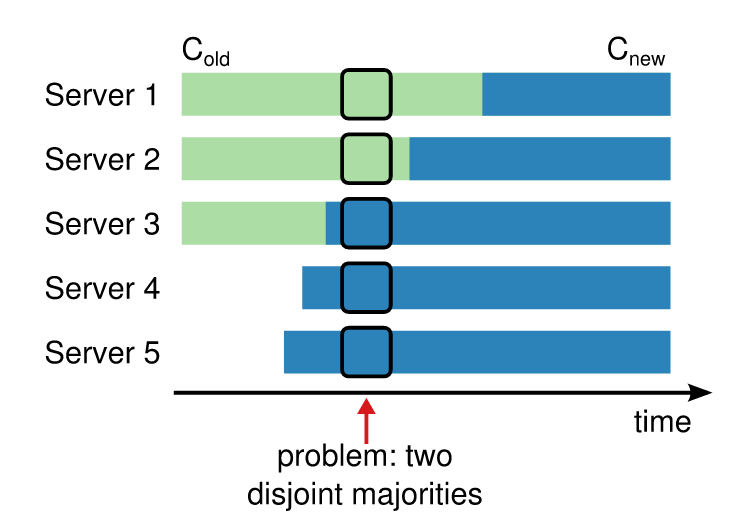
- $t_{1}$时刻,系统节点为${S_{1},S_{2},S_{3}}$,$S_{1}$为领导人
- $t_{2}$时刻,系统进行配置变更,添加两个成员${S_{4},S_{5}}$
- $t_{3}$时刻,$S{4},S_{5}$追加日志
- $t_{4}$时刻,$S_{3},S_{4},S_{5}$均提交该配置变更日志且$S_{3}$已应用新配置
- $t_{5}$时刻,$S_{3}$崩溃重启,$S_{4},S_{5}$应用新配置
- $t_{6}$时刻,$S_{1},S_{4}$先后超时竞选,$S_{1}$获得$S_{1},S_{2}$的选票,成为旧配置的领导人,$S_{4}$获得剩余三张选票,成为新配置的领导人
一个任期内,系统出现两个领导人,选举安全性被打破,根源在于多数派相交的前提被打破。
聪明的你,一定会想到,只要一次加入一个成员,那么一定能够保证多数派相交的前提成立。Raft-Extend图4.3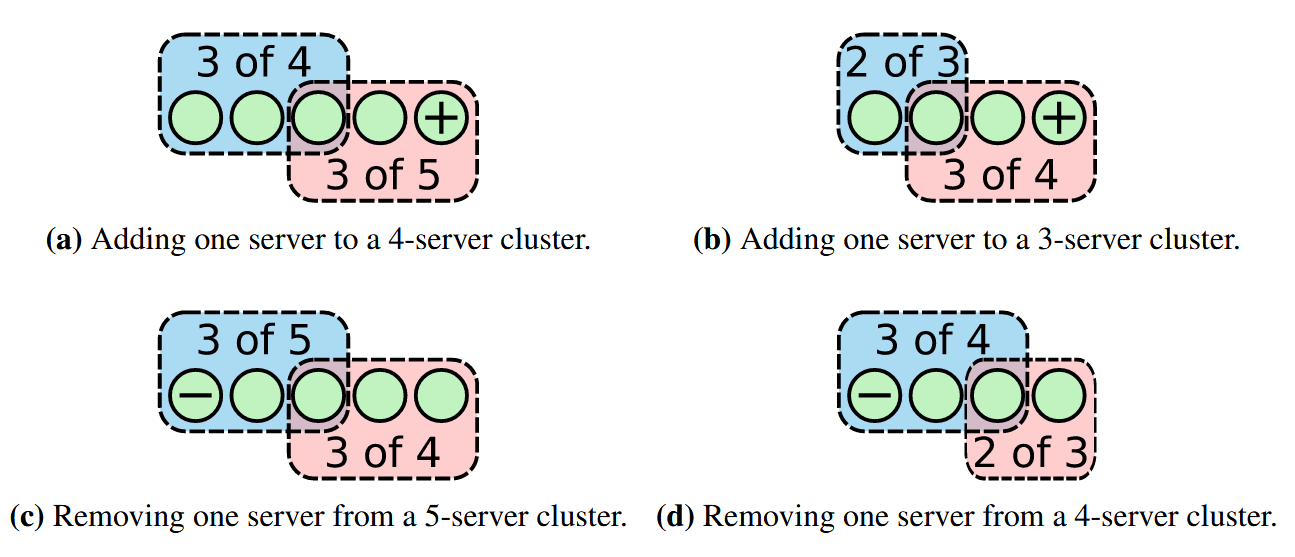
单点变更算法会损害可用性,因为系统从奇数个节点变更到偶数个节点时,容错能力没有提升,但是做出决策的节点数量却增加了。
以替换节点为例,对部署在三个故障域的节点a,b,c进行替换,将a替换为同一个故障域的节点d
假设采用先删再增的模式,那么在中间态b,c时如果某个节点崩溃,系统就会处于不可用状态,虽然是三节点集群,但是由于处于中间态导致无法容忍一个节点错误。
假设采用先增再删的模式,那么在中间态a,b,c,d时如果出现网络二分区,a,d位于一个分区,b,c位于一个分区,那么系统依旧处于不可用状态。下图引用自(1 封私信) Raft 成员变更上踩的坑 - 知乎
1 | a b c |
单点变更算法最大的问题在于不是原子操作,必须存在某个中间态,是否可以找到一种方法,能够原子地实现多个节点的配置变更呢?
从选举安全的前提出发:
- 一个节点在一个任期内最多投一张票
- 一个配置下两个多数派至少有一个相交节点
投票原则是无法放宽的,那么前提2呢?多数派相交的目的是确保两个做出决定的集合有交集,但两个做出决定的集合有交集是否需要多数派才能成立呢?
先做出定义,定义Majority表示一个集合中的多数派数量,即(N+1)/2,定义Quorum表示做出决定的集合的成员数量。
复用上述网络分区示例,假设我们将集合${b,c}$视为一个合法的Quorum,其余集合仍然使用Majority作为Quorum,系统因为不满足前提2从而违背选举安全性原则。
采用反证法来证明:
- 在网络分区前,节点集合为${a,b,c,d}$,在网络分区后,节点集合为${b,c}$和${a,d}$
- 网络分区前,主节点崩溃重启,某个节点选举超时,获得
Quorum票后成为领导人,其中投票人不包括$b$,在新领导人发送心跳/空的追加日志前,出现网络分区; - $b$选举超时,由于违背安全性,因此$b$胜选且只能因为获得${b,c}$的选票而成为领导人
- ${a,b,c,d}$不包含$b$的
Majority只能是${a,c,d}$,该Majority作为Quorum - 系统满足前提2, 与假设矛盾
很奇妙,很有意思,我们并不需要多数派就可以实现选举安全。那么究竟有哪些集合可以被视为合法的Quorum选用呢?
直接给出结论: $Q(C_{old},C_{new})=M(C_{old}) \cap M(C_{new})$
复用示例,可以得知:
- $M(C_{old})=M({a,b,c})={ab,bc,ac}$
- $M(C_{new})=M({b,c,d})={bc,bd,cd}$
- $Q(C_{old},C_{new})={abc,abd,acd,bcd,bc}$
JointConsensus算法核心就是将Quorum设置为新配置和旧配置多数派的交集,从而保证选举安全不被打破,并且实现多个节点原子提交。
一次配置变更需要两条日志提交:新旧配置联合日志,以及新配置
如果配置变更时领导人崩溃,新选出的领导人日志里没有C_old_new那么本次变更失败;如果有,那么继续配置变更。
在C_old_new提交后,C_new提交前,按照联合配置决定Quorum; 在新配置提交后,按照新配置决定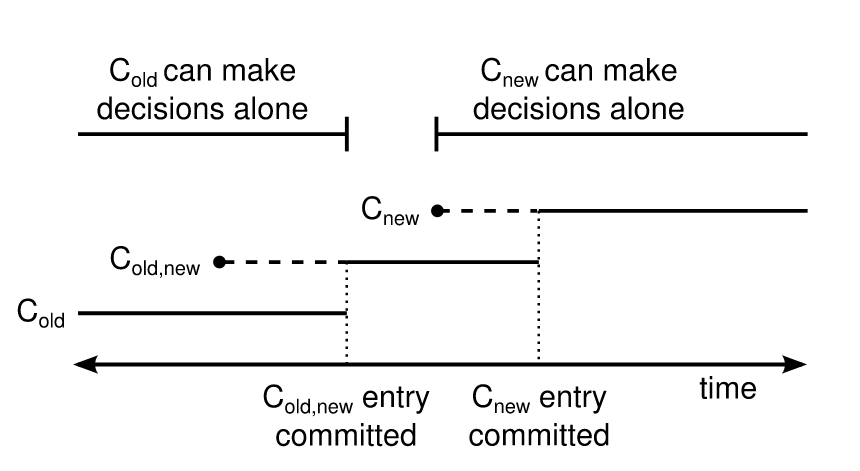
一些细节:
- 由于提交到
Quorum个节点后配置变更就算完成了,因此被删除的节点可能不知道自己被删了,因此频繁地超时竞选,工程上一般通过采用CheckQuorum来解决。只要节点近期收到过心跳,就直接丢弃任何投票请求。 - 领导人可能不在新配置后,因此新配置提交后,要么主动转移领导权,要么等一个选举超时
复制状态机
讨论raft算法如何与应用结合
本来计划结合代码讨论,但是写到这里有点力竭了,我要去爬塔了,先收个尾再说
共识算法的通用表现形式为复制状态机:
- 系统的写入/修改/线性一致读操作被抽象为日志条目,持久化地连续存储
- 系统从相同的起点/状态开始按照日志顺序应用操作并抵达某种状态
- 给定相同的操作,系统能抵达相同的状态
- 共识算法用于决定日志的顺序
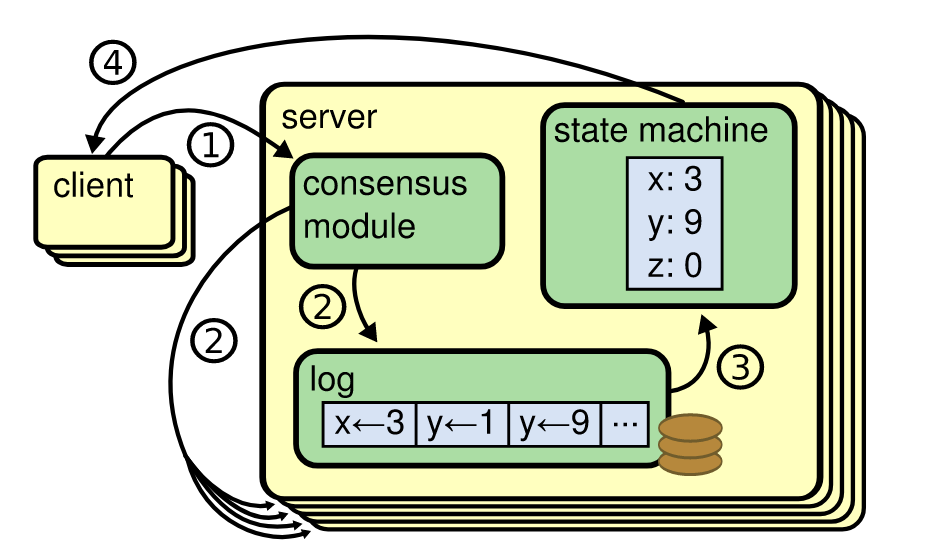
复制指的是一条日志在多个节点之间同步,使得只要多数节点存活,已提交的条目就不会丢失,且所有节点最终以相同顺序应用相同的条目。
主节点活跃时,只有主节点处理外部客户端的写入操作和线性一致性读取。
在主节点崩溃后,从节点会通过选举成为新的主节点对外提供服务。
由于上层应用多变,因此Raft算法库通常只实现核心算法、状态机和日志的抽象,即用户根据需求实现状态机和日志,注入给算法模块,同时用户需要自行处理Raft算法的事件循环以及网络传输openraft在此之上更进了一步,将事件循环和网络传输也打包处理了,用户只需要自定义元数据、网络传输接口、日志存储、状态机四个类型就可以享受到raft算法。
日志生命周期
etcd-raft只提供内存中运行的共识算法决策模块,将应用状态变更和消息网络传输交给应用层代码完成。etcd-raft使用unstable -> stable -> committed -> applied -> truncated状态转换表示日志的生命周期:
unsatble: 主节点生成并在内存保存日志条目(propose),此时该日志既没有被持久化(写入WAL),也没有达成共识(多数节点接收并持久化),此时如果主节点崩溃,那么会永久丢失。stable: 主节点将日志持久化,但是尚未达成共识committed: 日志达成共识,可以被上层应用applied: 日志被应用,状态机转换到新状态truncated: 为节省磁盘/内存,只保留最近一定数量的日志和快照,日志被裁剪
日志在内存中表现为连续数组,上述状态是数组下标,显然有truncated <= applied <= committed <= stable <= unstable
实际开发中committed & applied需要持久化,与Raft论文不同
持久化与快照
etcd默认保留5000条raft日志,每满5000条就做一次快照,记录最老的快照的lastIndex作为truncatedIndex,如果follower请求此前的日志,那么需要发送快照来快速跟进。
产生快照和传输快照都是高开销操作,传输快照通常使用流式接口,分块传输并且限流(100MB/s)。
产生快照的频率需要仔细设计,如果高频,那么磁盘写入开销大,如果低频,那么崩溃恢复时间长,需要在两者之间权衡。
推荐根据此前生成的快照大小和目前的WAL大小来估算,当WAL大小超过快照大小时,生成快照是有价值的。一般而言,倍率因子设置为2-4.etcd WAL采用分段设计,多条WAL存放到一个段(对应一个文件),清理时直接删除文件即可,简单高效。